Per migliorare le misurazioni della velocità della barra effettuate da Spleeft, ho raccolto dati in concomitanza con un encoder lineare durante l’allenamento con la squadra spagnola di BMX a Parigi. Ho riscritto l’algoritmo per iOS in Python e mi sono concentrato sul rilevamento dei periodi di riposo effettivi e delle ripetizioni complete, in cui il rumore del sensore avrebbe altrimenti potuto distorcere il risultato.
Ho iniziato a sviluppare Spleeft come progetto personale mentre lavoravo nel campo della preparazione fisica. La programmazione mi ha aiutato a trasformare le idee maturate durante l’attività di allenatore in uno strumento per misurare la velocità del bilanciere e mi ha offerto un modo per dimostrare ciò che ero in grado di fare al di fuori della palestra.
Man mano che l'intelligenza artificiale rendeva la programmazione più accessibile, ho iniziato a chiedermi dove avrei potuto dare il mio contributo maggiore. La risposta era proprio in quell'ambito che il codice da solo non riusciva a risolvere: interpretare i dati dei sensori e rendere le misurazioni più affidabili durante l'allenamento reale. Quella domanda mi ha portato al progetto sull'algoritmo che voglio condividere qui.
Prova Spleeft: Scarica Spleeft dall'App Store per monitorare la velocità del bilanciere con il tuo iPhone o Apple Watch.
Il problema della velocità della barra: deriva e false pause
La precedente ottimizzazione di Spleeft, che ho descritto in l'articolo originale sulla scienza dei dati, aveva una portata più limitata. Mi sono concentrato principalmente sulla regolazione dei parametri di un algoritmo esistente e sull’individuazione di combinazioni che ne migliorassero le prestazioni.
Quel lavoro è stato prezioso, ma dopo aver dedicato più tempo a testare Spleeft in contesti formativi reali, ho iniziato a intravedere un problema più profondo.
La difficoltà principale non consisteva semplicemente nel calcolare la velocità.
Si trattava di capire quando un movimento aveva inizio, quando terminava e quando il dispositivo era davvero immobile.
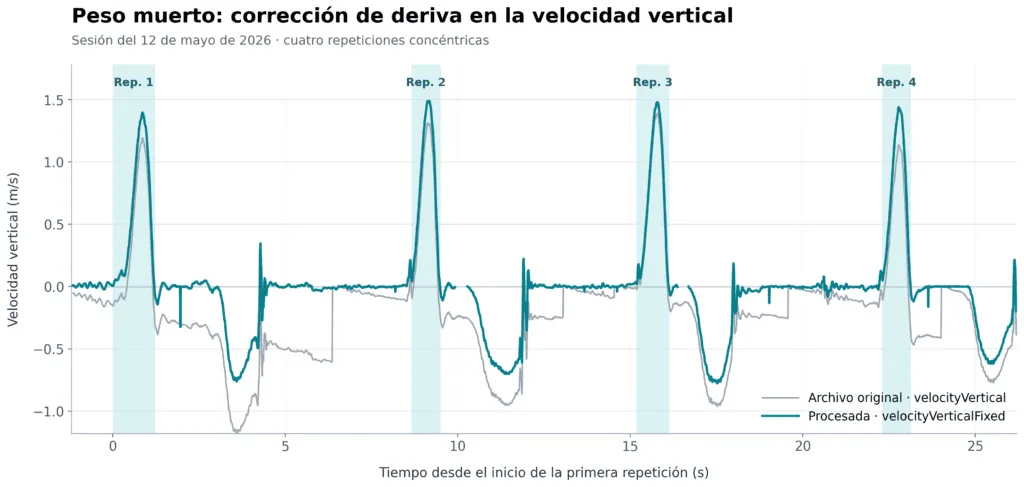
Spleeft utilizza i dati dell'accelerometro. Per calcolare la velocità, è necessario integrare l'accelerazione nel tempo. Si tratta di un approccio matematicamente elegante, ma che comporta anche un problema inevitabile: anche una minima deviazione o un minimo errore nel segnale di accelerazione si accumula durante l'integrazione e si traduce in una deriva della velocità.
Tale scostamento può derivare da diverse cause:
- rumore del sensore;
- piccole variazioni nell'orientamento del dispositivo;
- variazioni nel piano di movimento;
- errore di integrazione;
- filtraggio imperfetto;
- vibrazioni provenienti dall'atleta o dal bilanciere;
- periodi di bassa accelerazione mentre la barra è ancora in movimento.
L'ultimo punto è particolarmente importante. Un'accelerazione prossima allo zero non significa sempre che la velocità sia pari a zero. Può anche significare che la barra si sta muovendo a una velocità relativamente costante.
Pertanto, la vera sfida non consisteva semplicemente nel trovare “più zeri”.
Lo scopo era quello di trovare zeri migliori.
Lo zero è un punto di riferimento che può essere utilizzato per ricalibrare il segnale di velocità integrato. Se lo zero prima di una ripetizione è errato, l'integrazione parte da un punto sbagliato. Se all'interno di una ripetizione si verifica uno zero errato, il movimento potrebbe essere interrotto o ricalibrato troppo presto.
Ciò ha portato alla definizione di un nuovo principio per il progetto:
Per prima cosa, migliorare la qualità del rilevamento dello stato di riposo e della segmentazione delle ripetizioni. Successivamente, valutare la velocità.
Raccolta dei dati sulla velocità delle barre a Parigi
Il primo passo è stato quello di procurarsi un dispositivo di riferimento da utilizzare insieme a Spleeft.
Un noto produttore di encoder lineari aveva lanciato sul mercato un dispositivo in grado di fornire non solo i dati relativi alla velocità, ma anche i dati grezzi che potevano essere raccolti in un contesto di allenamento reale. Era esattamente ciò di cui avevo bisogno.
Durante un ritiro con la nazionale spagnola di BMX a Parigi, ho raccolto un ampio set di dati mentre svolgevo diversi esercizi:
- squat;
- stacchi da terra;
- power clean;
- salti da accovacciata;
- altri esercizi di potenziamento misti.
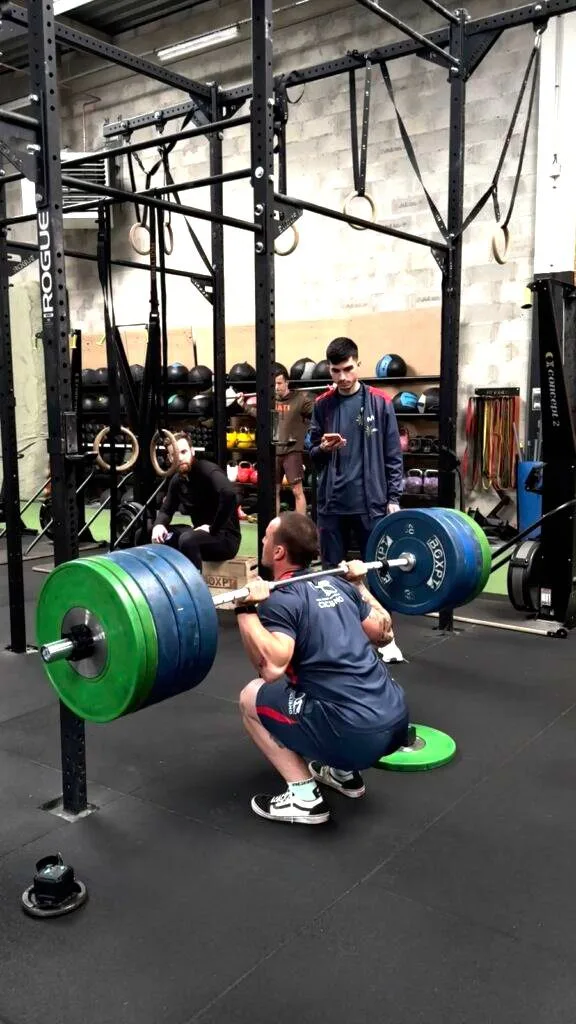
Le misurazioni sono state raccolte contemporaneamente:
- Spleeft ha registrato dati provenienti da accelerometri ad alta frequenza, comprese sessioni con frequenze fino a 800 Hz;
- l'encoder lineare registrava a circa 100 Hz.
Non si trattava di una serie di dati di laboratorio raccolti in condizioni perfettamente controllate. Era una scelta deliberata.
Volevo capire cosa succedesse quando il sistema veniva utilizzato negli ambienti in cui gli allenatori lo avrebbero effettivamente impiegato: con esercizi diversi, carichi diversi, pause diverse, strategie di movimento diverse e fonti di rumore diverse.
Il set di dati mi ha inoltre permesso di confrontare due tipi di misurazione molto diversi tra loro.
L'encoder misura il movimento lungo un percorso meccanico più ben definito. L'Apple Watch o l'iPhone misurano le forze che agiscono sul dispositivo, sulla barra e, indirettamente, sull'atleta. Non rilevano esattamente lo stesso segnale.
Quella differenza è diventata una delle lezioni più importanti del progetto.
Riscrittura di Spleeft in Python
Prima di ottimizzare qualsiasi cosa, ho dovuto riprodurre l'algoritmo iOS esistente al di fuori dell'applicazione.
Sembra semplice, ma è stata una delle parti più importanti dell’intero processo.
L'algoritmo di produzione gira in Swift su iPhone e Apple Watch. Il lavoro di ottimizzazione, tuttavia, è stato molto più semplice da svolgere in Python, dove ho potuto elaborare grandi set di dati, generare grafici e testare migliaia o milioni di combinazioni di parametri.
Il problema era che un'approssimazione in Python non sarebbe stata sufficiente.
Se la versione in Python si comportasse in modo diverso da quella in Swift, non starei ottimizzando Spleeft. Starei ottimizzando un algoritmo diverso.
Così ho sviluppato un simulatore in Python che riproduceva le principali fasi di elaborazione dell’implementazione per iOS:
- lettura dei dati dell'accelerometro e dei dati di movimento;
- ricostruzione della velocità;
- rilevare gli aggiornamenti a velocità zero;
- compensazione della deriva del segnale;
- segmentazione delle ripetizioni;
- calcolo della velocità media e di altri parametri.
Ho quindi verificato il simulatore confrontandolo con l'output di Swift. L'obiettivo non era quello di ottenere un risultato simile, ma di assicurarmi che lo stesso segnale grezzo producesse le stesse ripetizioni e metriche praticamente identiche.
Solo dopo questa fase l'ottimizzazione avrebbe potuto assumere un senso.
Oltre il rilevatore di zero originale
La prima versione dell'algoritmo prevedeva già la ricalibrazione a velocità zero, ma la sua logica era relativamente semplice.
Ha funzionato bene in situazioni controllate. Tuttavia, alcuni esercizi ne hanno messo in luce i punti deboli. La distensione su panca e lo stacco da terra si sono rivelati particolarmente impegnativi, poiché il dispositivo può subire movimenti aggiuntivi mentre l’atleta stabilizza il bilanciere.
Ho iniziato a esaminare approcci alternativi per il rilevamento della velocità zero attingendo alla letteratura scientifica e alle applicazioni correlate nel campo della navigazione inerziale.
Tra le idee figuravano:
- accelerazione filtrata su più assi;
- informazioni sul giroscopio;
- requisiti di persistenza tra campioni consecutivi;
- energia cinetica;
- controlli basati sulla deriva;
- rilevatori statistici conservativi;
- soglie diverse a seconda delle diverse fasi del movimento.
Non tutte le idee hanno funzionato.
Ad esempio, ho studiato un classificatore dello stato inerziale basato su un albero decisionale. Si è trattato di un utile esperimento di data science, ma le sue prestazioni non erano abbastanza affidabili da giustificarne l’utilizzo come criterio di esclusione definitivo nell’algoritmo di produzione.
Si trattava di una distinzione importante.
Il progetto prevedeva esperimenti di apprendimento automatico e metodi di data science, ma la soluzione finale implementata non era un modello “black-box” che si limitava a classificare ogni campione. Il processo di data science mi ha aiutato a comprendere il segnale, a identificare le modalità di guasto e a progettare una macchina a stati causali più robusta.
Il sistema finale è rimasto interpretabile.
Cercare tra milioni di possibilità
Una volta che il simulatore e i possibili rivelatori erano disponibili, ho iniziato a eseguire ricerche sistematiche dei parametri.
Per ciascuna configurazione candidata, gli stessi segnali grezzi sono stati elaborati nuovamente. I parametri controllavano aspetti quali:
- soglie di accelerazione;
- il numero minimo di campioni consecutivi;
- comportamento di filtraggio;
- regole di inserimento dei movimenti;
- regole relative ai movimenti e alle uscite;
- la quantità di prove necessarie prima della ricalibrazione;
- come il sistema gestiva le transizioni tra movimento e riposo.
La ricerca non era finalizzata a individuare la configurazione con l'errore di velocità più basso rispetto all'encoder.
Sarebbe stato troppo limitato.
L'obiettivo principale era quello di individuare la combinazione che consentisse di rilevare al meglio i periodi di velocità zero effettivi, evitando al contempo i falsi zeri durante il movimento attivo.
La valutazione si è svolta secondo un processo a cascata:
- Gli zeri effettivi sono stati rilevati correttamente?
- Le ripetizioni sono state suddivise in segmenti e conteggiate correttamente?
- Una volta soddisfatte le prime due condizioni, quanto erano vicine le metriche di velocità al riferimento esterno?
Questo ordine è importante.
Una ripetizione con una velocità vicina a quella dell'encoder non è necessariamente una ripetizione misurata correttamente se il suo inizio o la sua fine sono stati definiti da uno zero falso.
I numeri rappresentavano solo una parte dei criteri con cui valutavo ogni esperimento. Tenevo visibili sia le registrazioni grezze che le tracce di velocità risultanti, poi le confrontavo con i movimenti che avevo osservato durante il mio allenamento e nelle prove con i miei atleti. Quando c’era una pausa evidente, potevo verificare se l’algoritmo riportasse la velocità a zero. Quando una ripetizione era ancora in movimento, riuscivo a individuare una correzione errata. Quei semplici controlli visivi spesso mi fornivano più informazioni sulla modifica successiva da apportare rispetto a un altro punteggio di errore.
Una macchina a stati per il movimento
Uno dei principali miglioramenti dal punto di vista dell'architettura è stato l'aggiunta di una macchina a stati per integrare il rilevamento dello zero.
L'algoritmo ora analizza il movimento come una sequenza di stati, anziché trattare ogni campione in modo indipendente.
In parole povere, passa attraverso fasi quali:
- alla ricerca dell'inizio del movimento;
- rilevato movimento;
- alla ricerca della fine del movimento;
- che confermi un vero riposo post-movimento;
- ricalibrare il segnale.
Questa struttura contribuisce a evitare che singoli eventi dei sensori modifichino immediatamente l'interpretazione della ripetizione.
Ad esempio, un breve periodo di bassa accelerazione durante il movimento di una barra non dovrebbe essere automaticamente interpretato come un momento di riposo. Il sistema necessita di ulteriori indicazioni: la direzione del segnale, la durata dell’evento e il contesto più ampio del movimento.
La macchina a stati mi ha inoltre permesso di separare due concetti che in precedenza erano troppo strettamente collegati:
- rilevare se la barra si sta muovendo;
- stabilire se la velocità integrata possa essere ricalibrata.
Ciò si è rivelato particolarmente utile perché lo stato di movimento può rimanere attivo anche quando l'accelerazione è temporaneamente vicina allo zero.
Cosa l'encoder poteva — e non poteva — dirmi
Ho utilizzato l'encoder come riferimento esterno, ma non come verità assoluta.
Per ogni ripetizione, ho elaborato i dati dell'encoder utilizzando una metodologia analoga, anziché limitarmi a copiare le metriche esportate dal suo algoritmo proprietario. Ciò ha ridotto l'influenza delle differenze tra l'elaborazione interna dell'encoder e quella di Spleeft.
Anche allora, l'encoder veniva considerato un punto di riferimento, non uno standard assoluto.
I diversi dispositivi presentano filtri, ritardi, regole di rilevamento e vincoli meccanici diversi. Inoltre, il segnale esportato potrebbe non corrispondere esattamente al segnale utilizzato internamente per calcolare ciascuna metrica.
Ecco perché ho deciso di non definire il successo semplicemente come:
“Il valore di Spleeft è vicino al valore dell'encoder.”
Ho cercato invece un algoritmo che fosse internamente coerente, in grado di rilevare correttamente le ripetizioni e che funzionasse in modo affidabile in diversi esercizi e in diverse condizioni di registrazione.
L'encoder mi ha aiutato a individuare gli errori e ad analizzare i casi più complessi. Non ha sostituito il pensiero critico.
Test dell’algoritmo con dati reali degli utenti
Dopo gli esperimenti di laboratorio, sono tornato ad analizzare i dati raccolti al di fuori delle sessioni controllate.
Alcuni dei file più utili provenivano da utenti di Spleeft che avevano condiviso esempi di casi in cui l'applicazione aveva prodotto un risultato inaspettato.
Questi file erano preziosi perché contenevano i problemi che si presentano nella vita reale:
- pause imperfette;
- vibrazioni impreviste della barra;
- ripetizioni lente;
- diverse posizioni di fissaggio;
- cambiamenti nella tecnica;
- rumore prima o dopo la ripetizione;
- esercizi che non assomigliano allo squat.
Ho applicato il nuovo algoritmo a questi set di dati storici e ne ho confrontato il comportamento con quello dell'implementazione precedente.
Questa fase ha contribuito a mettere in luce un principio importante: migliorare l’algoritmo non significa renderlo più complesso a tutti i costi. Significa rendere la logica più adeguata alla realtà fisica del sensore e dell’esercizio.
Quell'esperienza ha anche contribuito a plasmare l'ultimo aggiornamento di Spleeft. Le misurazioni dell'accelerometro presentano dei limiti, anche dopo un'attenta ottimizzazione, quindi volevo che i coach potessero esaminare le registrazioni sottostanti e valutare se un risultato fosse attendibile nel proprio contesto.
Prova su un Apple Watch SE da 40 €
Volevo inoltre testare il nuovo algoritmo su un vero Apple Watch, anziché affidarmi esclusivamente alle simulazioni in Python.
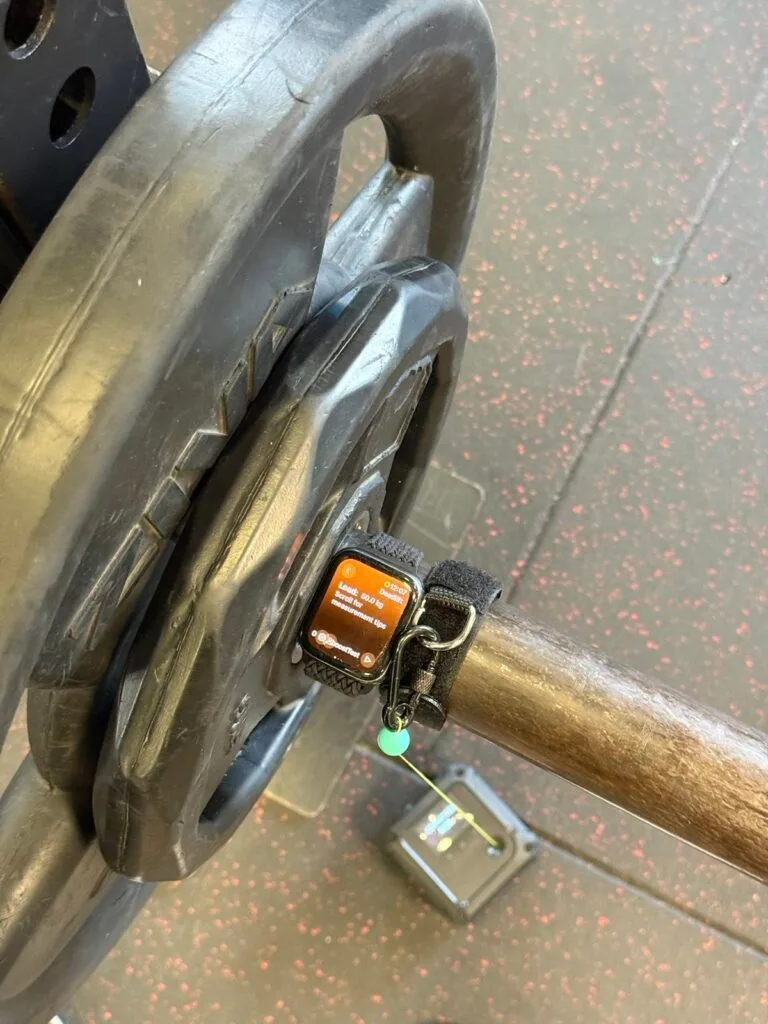
Per mantenere il progetto in linea con la filosofia originale di Spleeft, ho acquistato un Apple Watch SE di seconda mano per circa 40 euro. Era uno dei modelli più economici in grado di eseguire l’applicazione ed elaborare il segnale in tempo reale.
Non si è trattato solo di una prova pratica.
Spleeft è sempre stato concepito partendo dall'idea che l'allenamento basato sulla velocità debba essere accessibile a tutti. Se un nuovo algoritmo funzionasse solo sui dispositivi più costosi o in un ambiente di laboratorio perfetto, non sarebbe in linea con lo scopo del progetto.
Durante i test sul campo, ho messo a confronto due posizionamenti:
- l'orologio al polso dell'atleta;
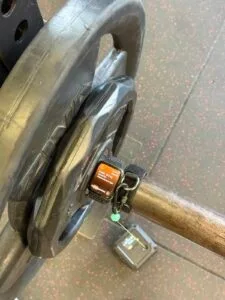
- l'orologio fissato direttamente alla barra.
Questo ha dimostrato quanto possa essere importante il posizionamento dei sensori.
Nel deadlift e nella distensione su panca, il movimento del polso dell’atleta può generare rumore aggiuntivo. L’atleta tiene e stabilizza il bilanciere, quindi il sensore non misura solo il movimento verticale del bilanciere, ma rileva anche i piccoli movimenti della mano, del polso e del corpo.
Appoggiando l'orologio direttamente sulla barra, il rumore si è in parte attenuato.
Ciò non significa che la posizione della barra sia sempre l'opzione migliore, né che quella del polso sia errata. Significa piuttosto che anche l'algoritmo ottimale deve tenere conto dei limiti dell'hardware e delle modalità di utilizzo del dispositivo.
Nessuna applicazione della scienza dei dati può compensare completamente una configurazione di misurazione inadeguata.
Cosa è cambiato nell’algoritmo di Spleeft
Il nuovo algoritmo ha superato la fase beta. La vera prova del nove sarà verificare la sua affidabilità in diversi esercizi, dispositivi e contesti di allenamento. Vorrei che fossero gli allenatori stessi a valutarlo.
Vorrei inoltre chiarire cosa si nasconde dietro quel numero: Spleeft utilizza i periodi di riposo rilevati per limitare la deriva della velocità e una macchina a stati per identificare le ripetizioni. Abbiamo verificato tali decisioni confrontandole con sessioni registrate e dispositivi esterni. Condivido l’approccio mantenendo riservati i parametri esatti.
Cosa ho imparato
Questo progetto mi ha insegnato che un indicatore di velocità efficace non dipende solo da un algoritmo ingegnoso. Dipende dal sensore, dall’esercizio, dalla qualità dei dati e dalle decisioni prese in ogni fase. L’intelligenza artificiale mi ha aiutato a esplorare e sviluppare più rapidamente, ma l’esperienza di coaching è stata fondamentale per stabilire quali fossero i problemi davvero rilevanti.
Spleeft è ancora un progetto personale nato proprio da quella curiosità. Continuerò a testarlo durante gli allenamenti reali e a condividere ciò che imparo.