Para mejorar las mediciones de velocidad de la barra de Spleeft, recopilé registros junto con un codificador lineal durante un entrenamiento con la selección española de BMX en París. Reescribí el algoritmo de iOS en Python y me centré en detectar los periodos de descanso reales y las repeticiones completas, en los que el ruido del sensor podría distorsionar el resultado.
Empecé a desarrollar Spleeft como un proyecto personal mientras trabajaba en el ámbito de la preparación física. La programación me ayudó a convertir las ideas que había adquirido como entrenador en una herramienta para medir la velocidad de la barra, y me brindó la oportunidad de demostrar lo que era capaz de hacer más allá del gimnasio.
A medida que la IA hacía que la programación resultara más accesible, empecé a preguntarme dónde podría aportar mi mayor contribución. La respuesta estaba en aquello que el código por sí solo no podía resolver: comprender los datos de los sensores y hacer que las mediciones fueran más fiables en el entrenamiento real. Esa pregunta me llevó al proyecto de algoritmos que quiero compartir aquí.
Prueba Spleeft: Descarga Spleeft en la App Store para medir la velocidad de la barra con tu iPhone o tu Apple Watch.
El problema de la velocidad de la barra: desviación y falsas pausas
La optimización anterior de Spleeft, que describí en el artículo original sobre ciencia de datos, tenía un alcance más limitado. Me centré principalmente en ajustar los parámetros de un algoritmo ya existente y en encontrar combinaciones que mejoraran su rendimiento.
Ese trabajo fue muy útil, pero tras dedicar más tiempo a probar Spleeft en entornos de formación reales, empecé a darme cuenta de que había un problema más profundo.
La principal dificultad no consistía simplemente en calcular la velocidad.
Se trataba de saber cuándo comenzaba un movimiento, cuándo terminaba y cuándo el dispositivo estaba realmente inmóvil.
Spleeft utiliza datos del acelerómetro. Para calcular la velocidad, es necesario integrar la aceleración a lo largo del tiempo. Esto resulta matemáticamente elegante, pero también plantea un problema inevitable: incluso un pequeño sesgo o error en la señal de aceleración se acumula durante la integración y se convierte en una deriva de la velocidad.
Esa desviación puede deberse a varias causas:
- ruido del sensor;
- pequeños cambios en la orientación del dispositivo;
- cambios en el plano de movimiento;
- error de integración;
- filtrado imperfecto;
- las vibraciones procedentes del deportista o de la barra;
- períodos de baja aceleración mientras la barra sigue en movimiento.
Este último punto es especialmente importante. Una aceleración cercana a cero no siempre significa que la velocidad sea cero. También puede significar que la barra se mueve a una velocidad relativamente constante.
Por lo tanto, el verdadero reto no consistía simplemente en encontrar “más ceros”.
El objetivo era encontrar mejores ceros.
Un cero es un momento que puede utilizarse para recalibrar la señal de velocidad integrada. Si el cero anterior a una repetición es incorrecto, la integración comienza desde un punto erróneo. Si aparece un falso cero dentro de una repetición, el movimiento puede interrumpirse o recalibrarse demasiado pronto.
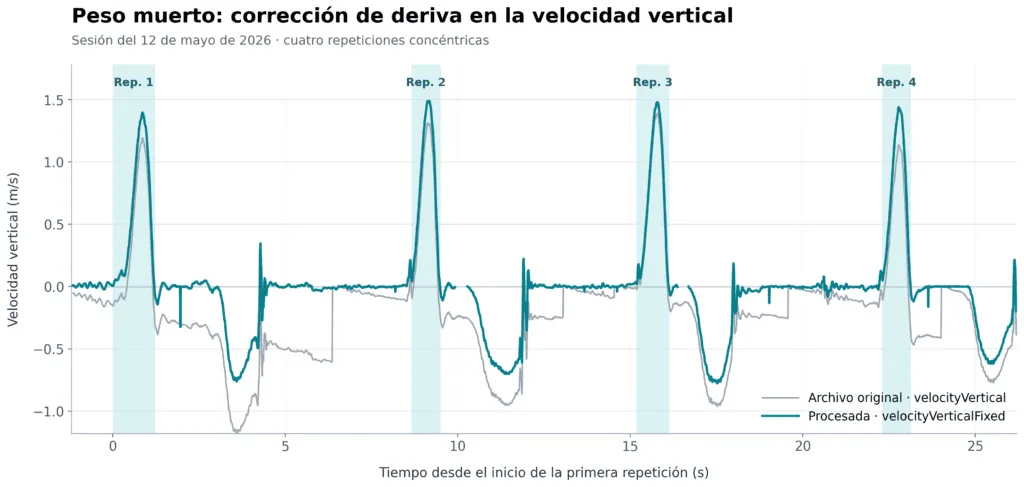
Esto dio lugar a un nuevo principio para el proyecto:
En primer lugar, mejora la calidad de la detección del estado de reposo y la segmentación de las repeticiones. A continuación, evalúa la velocidad.
Recopilación de datos sobre la velocidad de las barras en París
El primer paso consistió en conseguir un dispositivo de referencia que pudiera utilizarse junto con Spleeft.
Una reconocida empresa de codificadores lineales había lanzado al mercado un dispositivo capaz de proporcionar no solo la velocidad, sino también datos sin procesar que podían recopilarse en un contexto real de entrenamiento. Era justo lo que necesitaba.
Durante una concentración con la selección española de BMX en París, recopilé un amplio conjunto de datos mientras realizaba diferentes ejercicios:
- sentadillas;
- peso muerto;
- power cleans;
- saltos en cuclillas;
- otros ejercicios de fuerza combinados.
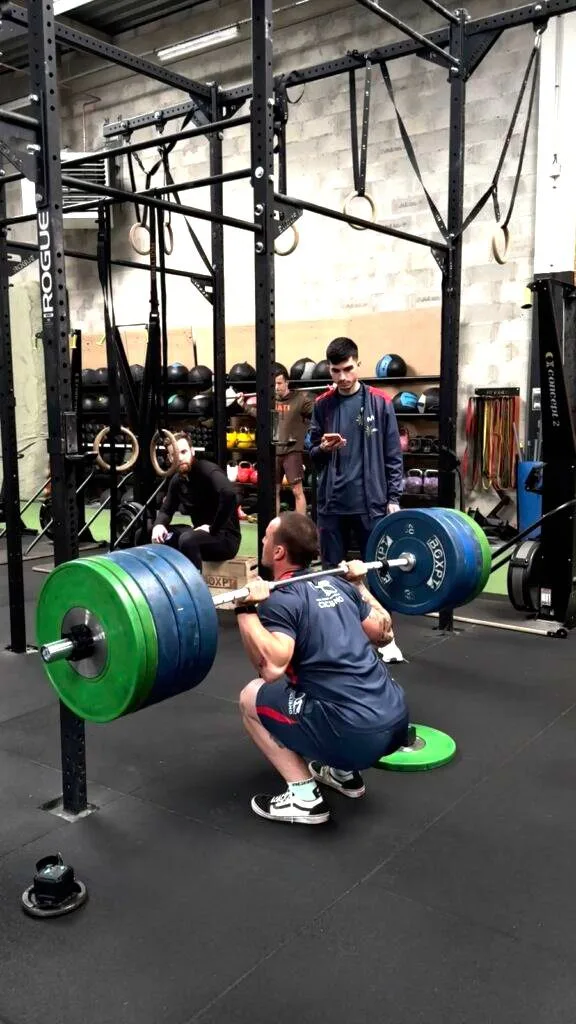
Las mediciones se recogieron simultáneamente:
- Spleeft registró datos de acelerómetros de alta frecuencia, incluidas sesiones a una frecuencia de hasta 800 Hz;
- el codificador lineal registraba datos a aproximadamente 100 Hz.
No se trataba de un conjunto de datos de laboratorio recopilado en condiciones perfectamente controladas. Eso fue a propósito.
Quería comprender qué ocurría cuando el sistema se utilizaba en los entornos en los que los entrenadores lo emplearían realmente: con diferentes ejercicios, diferentes cargas, diferentes pausas, diferentes estrategias de movimiento y diferentes fuentes de ruido.
El conjunto de datos también me permitió comparar dos tipos de medición muy diferentes.
El codificador mide el movimiento a lo largo de una trayectoria mecánica más definida. El Apple Watch o el iPhone miden las fuerzas que actúan sobre el dispositivo, la barra y, de forma indirecta, sobre el deportista. No detectan exactamente la misma señal.
Esa diferencia se convirtió en una de las lecciones más importantes del proyecto.
Recreación de Spleeft en Python
Antes de optimizar nada, tuve que reproducir el algoritmo existente de iOS fuera de la aplicación.
Parece sencillo, pero fue una de las partes más importantes de todo el proceso.
El algoritmo de producción se ejecuta en Swift en el iPhone y el Apple Watch. Sin embargo, el trabajo de optimización resultó mucho más sencillo de llevar a cabo en Python, donde pude procesar grandes conjuntos de datos, generar gráficos y probar miles o millones de combinaciones de parámetros.
El problema era que una aproximación en Python no sería suficiente.
Si la versión en Python se comportara de forma diferente a la versión en Swift, no estaría optimizando Spleeft. Estaría optimizando otro algoritmo.
Así que desarrollé un simulador en Python que reproducía las principales etapas de procesamiento de la implementación en iOS:
- leer los datos del acelerómetro y de movimiento;
- reconstrucción de la velocidad;
- detectar actualizaciones con velocidad nula;
- compensación de la deriva de la señal;
- segmentación de las repeticiones;
- cálculo de la velocidad media y otros parámetros.
A continuación, comparé el simulador con los resultados de Swift. El objetivo no era obtener un resultado similar, sino asegurarme de que la misma señal sin procesar generara el mismo número de repeticiones y, prácticamente, los mismos parámetros.
Solo tras este paso la optimización podría tener sentido.
Más allá del detector de cero original
La primera versión del algoritmo ya incluía la recalibración a velocidad cero, pero su lógica era relativamente sencilla.
Funcionó bien en situaciones controladas. Sin embargo, algunos ejercicios pusieron de manifiesto sus puntos débiles. El press de banca y el peso muerto resultaron especialmente difíciles, ya que el dispositivo puede experimentar movimientos adicionales mientras el deportista estabiliza la barra.
Empecé a investigar métodos alternativos de detección de velocidad cero a partir de la bibliografía científica y de aplicaciones relacionadas con la navegación inercial.
Entre las ideas se encontraban las siguientes:
- aceleración filtrada en varios ejes;
- información del giroscopio;
- requisitos de persistencia en muestras consecutivas;
- energía cinética;
- comprobaciones basadas en la desviación;
- detectores estadísticos conservadores;
- diferentes umbrales para los distintos estados del movimiento.
No todas las ideas funcionaron.
Por ejemplo, estudié un clasificador de estado inercial basado en árboles de decisión. Fue un experimento útil en el ámbito de la ciencia de datos, pero su rendimiento no era lo suficientemente fiable como para convertirse en un veto definitivo en el algoritmo de producción.
Se trataba de una distinción importante.
El proyecto incluía experimentos de aprendizaje automático y métodos de ciencia de datos, pero la solución final de producción no fue un modelo de «caja negra» que se limitara a clasificar cada muestra. El proceso de ciencia de datos me ayudó a comprender la señal, identificar los modos de fallo y diseñar una máquina de estados causal más robusta.
El sistema final siguió siendo interpretable.
Buscando entre millones de posibilidades
Una vez que dispuse del simulador y de los detectores candidatos, empecé a realizar búsquedas sistemáticas de parámetros.
Para cada configuración candidata, se volvieron a procesar las mismas señales sin procesar. Los parámetros controlaban aspectos tales como:
- umbrales de aceleración;
- el número mínimo de muestras consecutivas;
- comportamiento de filtrado;
- normas de introducción de movimientos;
- normas de salida de movimiento;
- la cantidad de pruebas necesarias antes de la recalibración;
- cómo gestionaba el sistema las transiciones entre el movimiento y el reposo.
La búsqueda no se diseñó para encontrar la configuración con el menor error de velocidad respecto al codificador.
Eso habría sido demasiado limitado.
El primer objetivo consistía en identificar la combinación que permitiera detectar mejor los períodos auténticos de velocidad cero, evitando al mismo tiempo los falsos ceros durante el movimiento activo.
La evaluación se llevó a cabo siguiendo un proceso en cascada:
- ¿Se han detectado correctamente los ceros efectivos?
- ¿Se han segmentado y contado correctamente las repeticiones?
- Una vez que las dos primeras condiciones resultaron aceptables, ¿en qué medida se acercaban los parámetros de velocidad a la referencia externa?
Este orden es importante.
Una repetición con una velocidad cercana a la del codificador no es necesariamente una repetición medida correctamente si su inicio o su fin se definieron a partir de un cero falso.
Las cifras eran solo una parte de cómo evaluaba cada experimento. Mantenía visibles los registros sin procesar y las curvas de velocidad resultantes, y luego las comparaba con los movimientos que había observado en mi propio entrenamiento y en las pruebas con mis deportistas. Cuando había una pausa evidente, podía ver si el algoritmo devolvía la velocidad a cero. Cuando una repetición seguía en movimiento, podía detectar una corrección errónea. Esas sencillas comprobaciones visuales a menudo me daban más información sobre el siguiente cambio que debía realizar que otra puntuación de error.
Una máquina de estados para el movimiento
Una de las principales mejoras arquitectónicas fue la incorporación de una máquina de estados para complementar la detección de ceros.
Ahora, el algoritmo analiza el movimiento como una secuencia de estados, en lugar de tratar cada muestra de forma independiente.
En términos sencillos, pasa por etapas como:
- en busca del origen del movimiento;
- se ha detectado movimiento;
- en busca del final del movimiento;
- que confirme un verdadero reposo tras el movimiento;
- recalibrar la señal.
Esta estructura ayuda a evitar que los eventos aislados de los sensores modifiquen de inmediato la interpretación de la repetición.
Por ejemplo, un breve periodo de baja aceleración durante el movimiento de una barra no debería interpretarse automáticamente como reposo. El sistema necesita pruebas adicionales: la dirección de la señal, la duración del evento y el contexto general del movimiento.
La máquina de estados también me permitió separar dos ideas que antes estaban demasiado entrelazadas:
- detectar si la barra se está moviendo;
- decidir si la velocidad integrada puede recalibrarse.
Esto resultaba especialmente útil porque un estado de movimiento puede permanecer activo incluso cuando la aceleración se aproxima temporalmente a cero.
Lo que el codificador podía —y no podía— decirme
Utilicé el codificador como referencia externa, pero no como una verdad de referencia incuestionable.
En cada repetición, procesé los datos del codificador utilizando una metodología similar, en lugar de limitarme a copiar las métricas exportadas por su algoritmo propio. Esto redujo la influencia de las diferencias entre el procesamiento interno del codificador y el de Spleeft.
Aun así, el codificador se consideraba una referencia, no un estándar absoluto.
Los distintos dispositivos tienen diferentes filtros, retrasos, reglas de detección y limitaciones mecánicas. Además, es posible que la señal exportada no sea exactamente la misma que se utiliza internamente para calcular cada métrica.
Por eso decidí no definir el éxito simplemente como:
“El valor de Spleeft es similar al valor del codificador”.”
En su lugar, busqué un algoritmo que fuera coherente en sí mismo, que detectara correctamente las repeticiones y que funcionara de forma fiable en diferentes ejercicios y condiciones de grabación.
El codificador me ayudó a identificar errores y a investigar casos complicados. No sustituyó al pensamiento crítico.
Prueba del algoritmo con datos reales de usuarios
Tras los experimentos de laboratorio, volví a analizar los datos recopilados fuera de las sesiones controladas.
Algunos de los archivos más útiles procedían de usuarios de Spleeft que habían compartido ejemplos de casos en los que la aplicación había dado un resultado inesperado.
Estos archivos resultaban valiosos porque recogían los problemas que surgen en la vida real:
- pausas imperfectas;
- vibraciones inesperadas en la barra;
- repeticiones lentas;
- diferentes posiciones de fijación;
- cambios en la técnica;
- ruido antes o después de la repetición;
- ejercicios que no se parecen a una sentadilla.
Apliqué el nuevo algoritmo a estos conjuntos de datos históricos y comparé su comportamiento con el de la implementación anterior.
Esta fase ayudó a poner de manifiesto un principio importante: mejorar el algoritmo no significa complicarlo a toda costa. Significa adaptar mejor la lógica a la realidad física del sensor y del ejercicio.
Esa experiencia también marcó la última actualización de Spleeft. Las mediciones del acelerómetro tienen sus limitaciones, incluso tras una optimización minuciosa, por lo que quería que los entrenadores pudieran examinar las grabaciones subyacentes y valorar si un resultado es fiable en su propio contexto.
Pruebas realizadas con un Apple Watch SE de 40 €
También quería probar el nuevo algoritmo en un Apple Watch real, en lugar de basarme únicamente en simulaciones en Python.
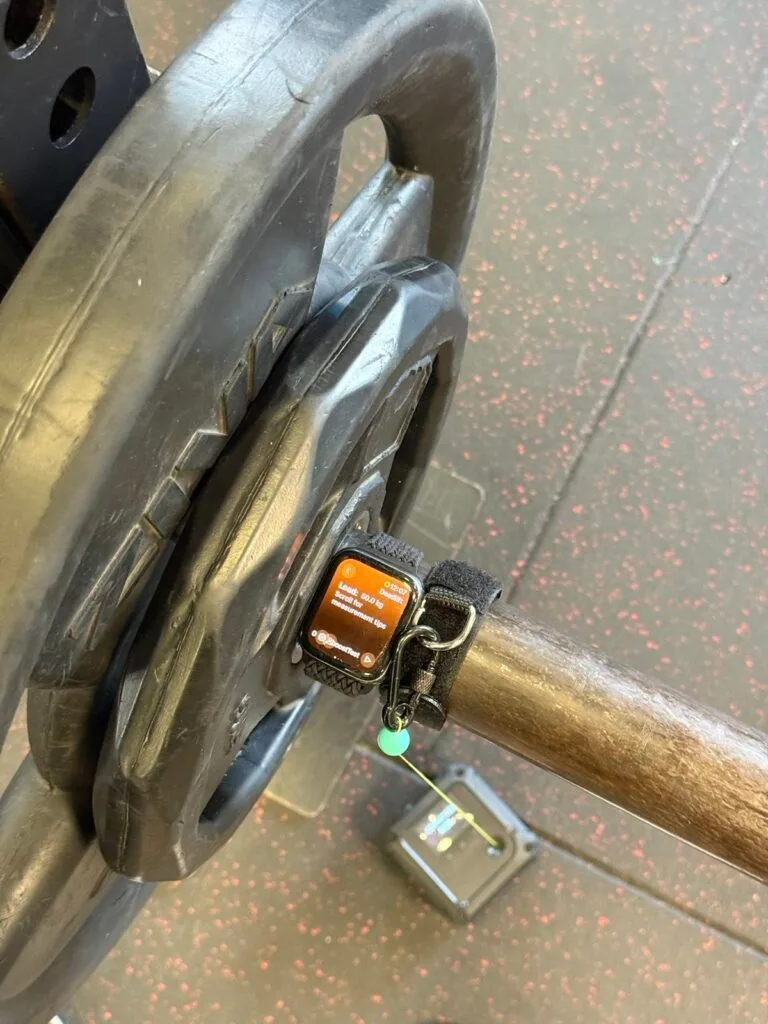
Para que el proyecto se mantuviera fiel a la filosofía original de Spleeft, compré un Apple Watch SE de segunda mano por unos 40 €. Era uno de los modelos más económicos capaces de ejecutar la aplicación y procesar la señal en tiempo real.
Esto fue algo más que una prueba práctica.
Spleeft siempre se ha basado en la idea de que el entrenamiento basado en la velocidad debe ser accesible. Si un nuevo algoritmo solo funcionara en el dispositivo más caro o en un entorno de laboratorio perfecto, no se ajustaría al objetivo del proyecto.
Durante las pruebas de campo, comparé dos ubicaciones:
- el reloj que lleva el deportista en la muñeca;
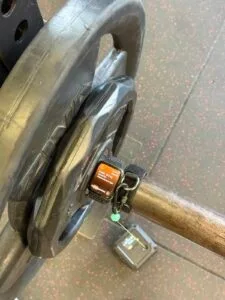
- el reloj fijado directamente a la barra.
Esto puso de manifiesto lo importante que puede ser la ubicación de los sensores.
En el peso muerto y el press de banca, el movimiento de la muñeca del deportista puede generar ruido adicional. El deportista sujeta y estabiliza la barra, por lo que el sensor no solo mide el movimiento vertical de la barra, sino que también registra pequeños movimientos de la mano, la muñeca y el cuerpo.
Al colocar el reloj directamente sobre la barra, se redujo parte de ese ruido.
Esto no significa que la posición de la barra sea siempre la mejor opción, ni que la posición de la muñeca sea incorrecta. Significa que el mejor algoritmo también debe tener en cuenta las limitaciones del hardware y la forma en que se utiliza el dispositivo.
Por mucho que se recurra a la ciencia de datos, nunca se podrá compensar por completo una configuración de medición deficiente.
¿Qué ha cambiado en el algoritmo de Spleeft?
El nuevo algoritmo ya ha superado la fase beta. La verdadera prueba será comprobar su consistencia en diferentes ejercicios, dispositivos y entornos de entrenamiento. Quiero que los entrenadores puedan valorarlo por sí mismos.
También quiero dejar claro qué hay detrás de esa cifra: Spleeft utiliza los periodos de descanso detectados para limitar la desviación de la velocidad y una máquina de estados para identificar las repeticiones. Hemos comprobado esas decisiones comparándolas con sesiones grabadas y dispositivos externos. Comparto este enfoque, aunque mantengo en secreto los parámetros exactos.
Lo que he aprendido
Este proyecto me enseñó que una métrica de velocidad útil no solo depende de un algoritmo ingenioso. Depende del sensor, del ejercicio, de la calidad de los datos y de las decisiones que se toman en cada paso. La inteligencia artificial me ayudó a explorar y desarrollar más rápido, pero la experiencia como entrenador fue fundamental para decidir qué problemas eran los más importantes.
Spleeft sigue siendo un proyecto personal que surge de esa curiosidad. Seguiré probándolo en sesiones de entrenamiento reales y compartiendo lo que aprenda.