Para melhorar as medições de velocidade do guiador do Spleeft, recolhi registos em paralelo com um codificador linear durante um treino com a equipa espanhola de BMX em Paris. Recriei o algoritmo do iOS em Python e concentrei-me na deteção de períodos de descanso reais e de repetições completas, em que o ruído do sensor poderia, de outra forma, distorcer o resultado.
Comecei a desenvolver o Spleeft como um projeto pessoal enquanto trabalhava na preparação física. A programação ajudou-me a transformar ideias do treino numa ferramenta para medir a velocidade da barra e deu-me uma forma de mostrar o que era capaz de fazer para além do ginásio.
À medida que a IA tornou a programação mais acessível, comecei a questionar-me sobre onde poderia dar o meu maior contributo. A resposta estava naquilo que o código, por si só, não conseguia resolver: compreender os dados dos sensores e tornar as medições mais fiáveis no treino real. Essa questão levou ao projeto de algoritmos que pretendo partilhar aqui.
Experimenta o Spleeft: Descarrega o Spleeft na App Store para monitorizar a velocidade da barra com o teu iPhone ou Apple Watch.
O problema da velocidade da barra: desvio e falsas pausas
A otimização anterior do Spleeft, que descrevi em o artigo original sobre ciência de dados, teve um âmbito mais restrito. Concentrei-me principalmente em ajustar os parâmetros de um algoritmo já existente e em encontrar combinações que melhorassem o seu desempenho.
Esse trabalho foi valioso, mas depois de passar mais tempo a testar o Spleeft em ambientes de formação reais, comecei a perceber que havia um problema mais profundo.
A principal dificuldade não residia simplesmente no cálculo da velocidade.
Era saber quando um movimento começava, quando terminava e quando o aparelho estava realmente imóvel.
O Spleeft utiliza dados do acelerómetro. Para calcular a velocidade, é necessário integrar a aceleração ao longo do tempo. Esta abordagem é matematicamente elegante, mas também cria um problema inevitável: mesmo um pequeno desvio ou erro no sinal de aceleração acumula-se durante a integração e transforma-se num desvio de velocidade.
Essa variação pode ter várias origens:
- ruído do sensor;
- pequenas alterações na orientação do dispositivo;
- alterações no plano de movimento;
- erro de integração;
- filtragem imperfeita;
- vibrações provenientes do atleta ou da barra;
- períodos de baixa aceleração enquanto a barra ainda se encontra em movimento.
Este último ponto é particularmente importante. Uma aceleração próxima de zero nem sempre significa que a velocidade seja zero. Pode também significar que a barra se está a mover a uma velocidade relativamente constante.
Por isso, o verdadeiro desafio não consistia simplesmente em encontrar “mais zeros”.
O objetivo era encontrar melhores zeros.
Um zero é um momento que pode ser utilizado para recalibrar o sinal de velocidade integrado. Se o zero antes de uma repetição estiver errado, a integração começa a partir do ponto errado. Se surgir um falso zero no meio de uma repetição, o movimento pode ser interrompido ou recalibrado demasiado cedo.
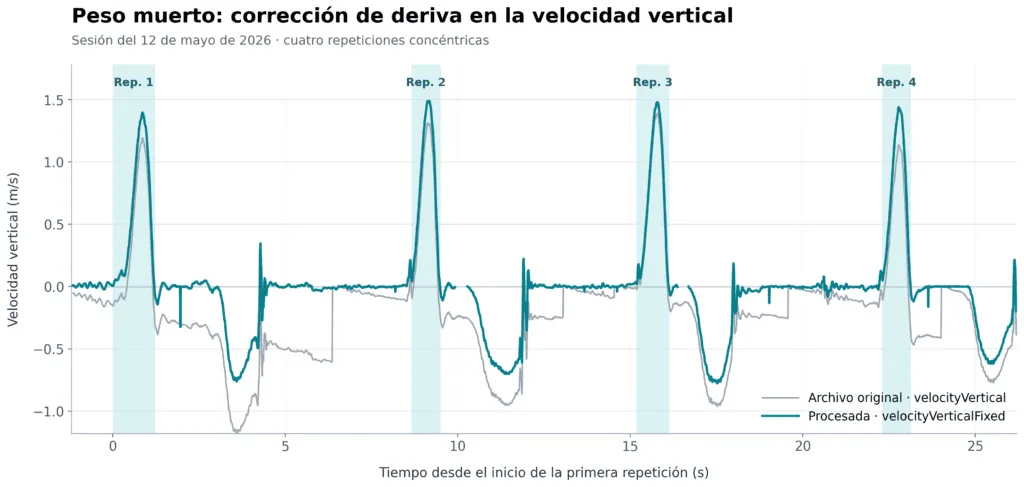
Isto levou à definição de um novo princípio para o projeto:
Primeiro, melhore a qualidade da deteção do estado de repouso e da segmentação das repetições. Em seguida, avalie a velocidade.
Recolha de dados sobre a velocidade nas barras em Paris
O primeiro passo consistiu em obter um dispositivo de referência que pudesse ser utilizado em conjunto com o Spleeft.
Uma empresa reconhecida no setor dos codificadores lineares tinha lançado um dispositivo capaz de fornecer não só a velocidade, mas também dados brutos que podiam ser recolhidos num contexto real de treino. Era exatamente isso de que eu precisava.
Durante um estágio com a seleção espanhola de BMX em Paris, recolhi um vasto conjunto de dados enquanto realizava diferentes exercícios:
- agachamentos;
- levantamentos terra;
- power cleans;
- saltos em agachamento;
- outros exercícios de força mista.
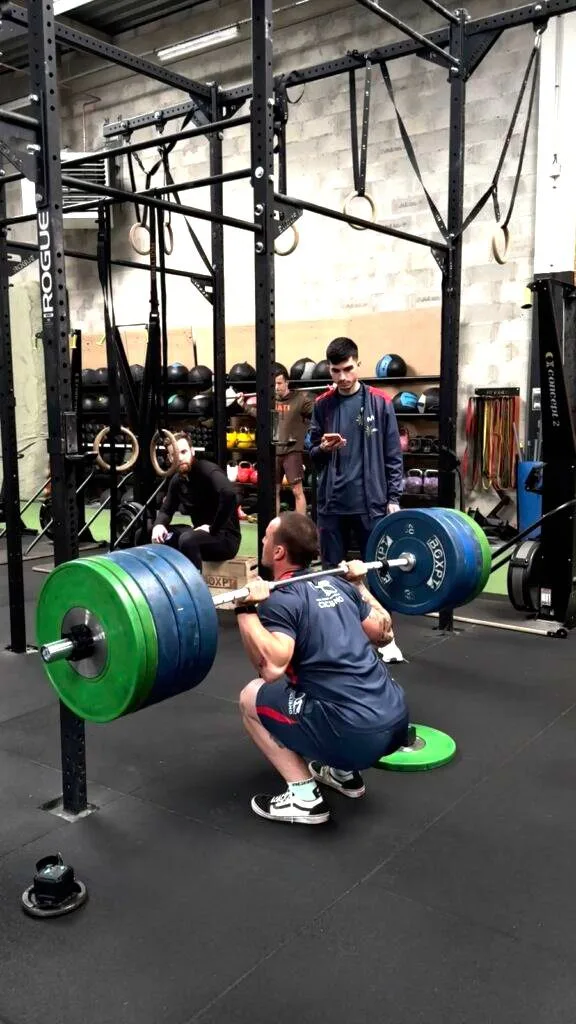
As medições foram recolhidas simultaneamente:
- O Spleeft registou dados de acelerómetros de alta frequência, incluindo sessões a até 800 Hz;
- o codificador linear registava dados a uma frequência de aproximadamente 100 Hz.
Este não era um conjunto de dados de laboratório recolhido em condições perfeitamente controladas. Isso foi intencional.
Queria compreender o que acontecia quando o sistema era utilizado nos ambientes em que os treinadores o utilizariam na prática: com diferentes exercícios, diferentes cargas, diferentes pausas, diferentes estratégias de movimento e diferentes fontes de ruído.
O conjunto de dados também me permitiu comparar dois tipos de medição muito diferentes.
O codificador mede o movimento ao longo de um percurso mecânico mais definido. O Apple Watch ou o iPhone medem as forças que atuam sobre o dispositivo, a barra e, indiretamente, o atleta. Não captam exatamente o mesmo sinal.
Essa diferença tornou-se uma das lições mais importantes do projeto.
Recriar o Spleeft em Python
Antes de otimizar qualquer coisa, tive de reproduzir o algoritmo existente do iOS fora da aplicação.
Isto parece simples, mas foi uma das partes mais importantes de todo o processo.
O algoritmo de produção é executado em Swift no iPhone e no Apple Watch. O trabalho de otimização, no entanto, foi muito mais fácil de realizar em Python, onde pude processar grandes conjuntos de dados, gerar gráficos e testar milhares ou milhões de combinações de parâmetros.
O problema era que uma aproximação em Python não seria suficiente.
Se a versão em Python se comportasse de forma diferente da versão em Swift, eu não estaria a otimizar o Spleeft. Estaria a otimizar um algoritmo diferente.
Por isso, desenvolvi um simulador em Python que reproduzia as principais etapas de processamento da implementação no iOS:
- ler os dados do acelerómetro e de movimento;
- velocidade de reconstrução;
- detetar atualizações de velocidade nula;
- compensação da deriva do sinal;
- segmentação de repetições;
- cálculo da velocidade média e de outros indicadores.
Em seguida, comparei o simulador com os resultados do Swift. O objetivo não era obter um resultado semelhante, mas sim certificar-me de que o mesmo sinal bruto produzia as mesmas repetições e métricas praticamente idênticas.
Só após esta etapa é que a otimização poderia passar a ter sentido.
Olhar para além do detetor de zero original
A primeira versão do algoritmo já incluía a recalibração à velocidade zero, mas a sua lógica era relativamente simples.
Funcionou bem em situações controladas. No entanto, alguns exercícios revelaram as suas fraquezas. O supino e o levantamento terra revelaram-se particularmente desafiantes, uma vez que o aparelho pode sofrer movimentos adicionais enquanto o atleta estabiliza a barra.
Comecei a investigar abordagens alternativas para a deteção de velocidade nula, com base na literatura científica e em aplicações relacionadas com a navegação inercial.
Algumas das ideias incluíam:
- aceleração filtrada em vários eixos;
- informações do giroscópio;
- requisitos de persistência ao longo de amostras consecutivas;
- energia cinética;
- verificações baseadas no desvio;
- detetores estatísticos conservadores;
- limiares diferentes para os diferentes estados do movimento.
Nem todas as ideias resultaram.
Por exemplo, explorei um classificador de estado inercial baseado em árvores de decisão. Foi uma experiência útil no âmbito da ciência de dados, mas o seu desempenho não foi suficientemente fiável para se tornar um critério de exclusão definitivo no algoritmo de produção.
Esta foi uma distinção importante.
O projeto envolveu experiências de aprendizagem automática e métodos de ciência de dados, mas a solução final de produção não foi um modelo de «caixa preta» que se limitasse a classificar todas as amostras. O processo de ciência de dados ajudou-me a compreender o sinal, a identificar modos de falha e a conceber uma máquina de estados causal mais robusta.
O sistema final manteve-se interpretável.
Pesquisar entre milhões de possibilidades
Assim que o simulador e os detetores candidatos ficaram disponíveis, comecei a realizar pesquisas sistemáticas de parâmetros.
Para cada configuração candidata, os mesmos sinais brutos foram processados novamente. Os parâmetros controlavam aspetos como:
- limiares de aceleração;
- o número mínimo de amostras consecutivas;
- comportamento de filtragem;
- regras de introdução de movimentos;
- regras de saída de movimento;
- a quantidade de provas necessárias antes da recalibração;
- como o sistema geria as transições entre o movimento e o repouso.
A pesquisa não foi concebida para encontrar a configuração com o menor erro de velocidade em relação ao codificador.
Isso teria sido demasiado restrito.
O primeiro objetivo consistiu em identificar a combinação que melhor detetasse períodos genuínos de velocidade nula, evitando simultaneamente falsos zeros durante o movimento ativo.
A avaliação seguiu um processo em cascata:
- Os zeros efetivos foram detetados corretamente?
- As repetições foram segmentadas e contadas corretamente?
- Uma vez que as duas primeiras condições foram consideradas aceitáveis, qual era o grau de proximidade das métricas de velocidade em relação à referência externa?
Esta ordem é importante.
Uma repetição com uma velocidade próxima da do codificador não é necessariamente uma repetição medida corretamente se o seu início ou fim tiver sido definido por um falso zero.
Os números eram apenas uma parte da forma como avaliei cada experiência. Mantive os registos brutos e os traços de velocidade resultantes visíveis e, em seguida, comparei-os com os movimentos que tinha observado no meu próprio treino e nos testes com os meus atletas. Quando havia uma pausa óbvia, conseguia ver se o algoritmo repunha a velocidade a zero. Quando uma repetição ainda estava em movimento, conseguia identificar uma correção errada. Essas verificações visuais simples muitas vezes diziam-me mais sobre a próxima alteração a fazer do que mais uma pontuação de erro.
Uma máquina de estados para o movimento
Uma das principais melhorias arquitetónicas consistiu na adição de uma máquina de estados para complementar a deteção de zeros.
O algoritmo passa agora a analisar o movimento como uma sequência de estados, em vez de tratar cada amostra de forma independente.
Em termos simplificados, passa por fases como:
- à procura do início do movimento;
- detetou-se movimento;
- à procura do fim do movimento;
- confirmando um verdadeiro repouso após o movimento;
- recalibrar o sinal.
Esta estrutura ajuda a evitar que eventos isolados dos sensores alterem imediatamente a interpretação da repetição.
Por exemplo, um curto período de baixa aceleração durante o movimento de uma barra não deve ser automaticamente interpretado como repouso. O sistema necessita de indícios adicionais: a direção do sinal, a persistência do evento e o contexto mais amplo do movimento.
A máquina de estados também me permitiu separar duas ideias que, anteriormente, estavam demasiado interligadas:
- detetar se a barra está a mover-se;
- decidir se a velocidade integrada pode ser recalibrada.
Isto revelou-se especialmente útil porque um estado de movimento pode permanecer ativo mesmo quando a aceleração está temporariamente próxima de zero.
O que o codificador me podia — e não me podia — dizer
Utilizei o codificador como referência externa, mas não como uma verdade absoluta.
Em cada repetição, processei os dados do codificador utilizando uma metodologia comparável, em vez de me limitar a copiar as métricas exportadas pelo seu algoritmo proprietário. Isto reduziu a influência das diferenças entre o processamento interno do codificador e o processamento do Spleeft.
Mesmo assim, o codificador era considerado uma referência, e não um padrão absoluto.
Os diferentes dispositivos têm filtros, atrasos, regras de deteção e restrições mecânicas diferentes. Além disso, o sinal exportado pode não ser exatamente o mesmo que é utilizado internamente para calcular todas as métricas.
É por isso que decidi não definir o sucesso simplesmente como:
“O valor do Spleeft está próximo do valor do codificador.”
Em vez disso, procurei um algoritmo que fosse internamente consistente, detetasse as repetições corretamente e se comportasse de forma robusta em diferentes exercícios e condições de gravação.
O codificador ajudou-me a identificar erros e a investigar casos complexos. Não substituiu o pensamento crítico.
Testar o algoritmo com dados reais de utilizadores
Após as experiências laboratoriais, voltei a analisar os dados recolhidos fora das sessões controladas.
Alguns dos ficheiros mais úteis vieram de utilizadores do Spleeft que partilharam exemplos de casos em que a aplicação produziu um resultado inesperado.
Estes ficheiros eram valiosos porque continham os problemas que surgem na vida real:
- pausas imperfeitas;
- vibrações inesperadas na barra;
- repetições lentas;
- diferentes posições de fixação;
- mudanças na técnica;
- ruído antes ou depois da repetição;
- exercícios que não se assemelham a um agachamento.
Apliquei o novo algoritmo a estes conjuntos de dados históricos e comparei o seu comportamento com o da implementação anterior.
Esta fase ajudou a revelar um princípio importante: melhorar o algoritmo não significa torná-lo mais complicado a qualquer custo. Significa tornar a lógica mais bem adaptada à realidade física do sensor e do exercício.
Essa experiência também marcou a última atualização do Spleeft. As medições do acelerómetro têm limitações, mesmo após uma otimização cuidadosa, por isso queria que os treinadores pudessem analisar as gravações subjacentes e avaliar se um resultado é fiável no seu próprio contexto.
Testes num Apple Watch SE de 40 €
Também queria testar o novo algoritmo num Apple Watch real, em vez de me basear apenas em simulações em Python.
Para manter o projeto alinhado com a filosofia original do Spleeft, comprei um Apple Watch SE em segunda mão por cerca de 40 €. Era um dos modelos mais baratos capazes de executar a aplicação e processar o sinal em tempo real.
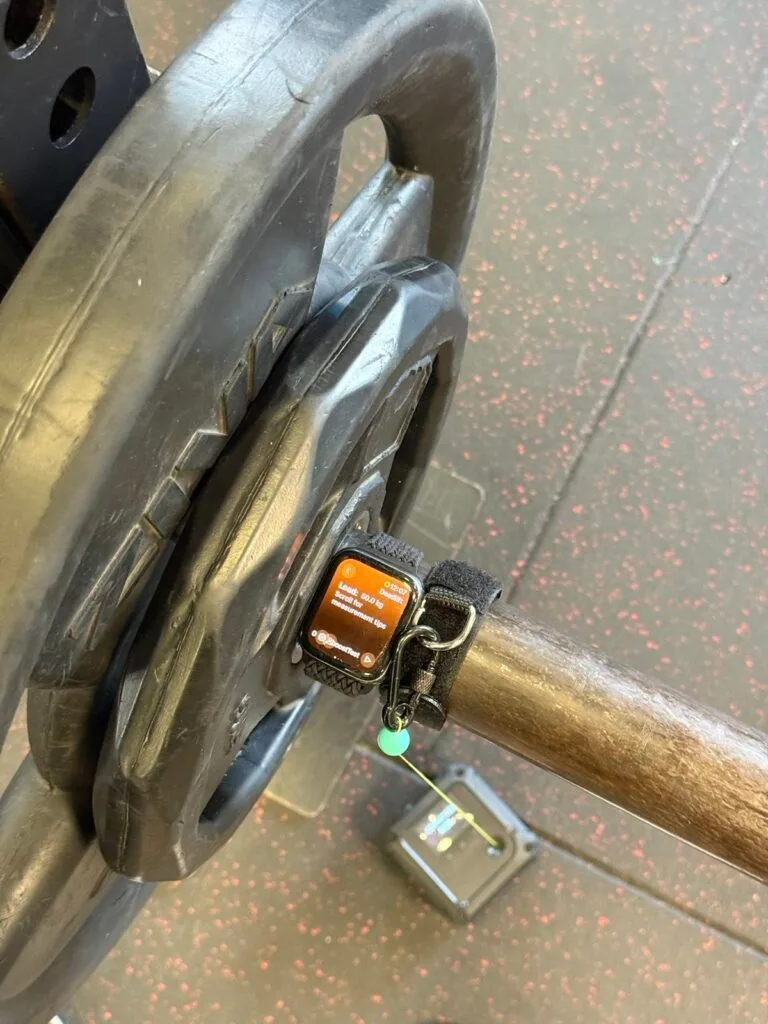
Isto foi mais do que um teste prático.
O Spleeft sempre se baseou na ideia de que o treino baseado na velocidade deve ser acessível. Se um novo algoritmo só funcionasse no dispositivo mais caro ou num ambiente laboratorial perfeito, não se enquadraria no objetivo do projeto.
Durante os testes no terreno, comparei duas disposições:
- o relógio no pulso do atleta;
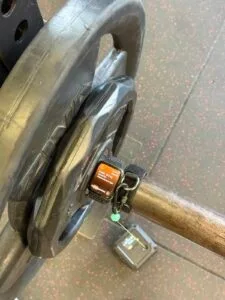
- o relógio fixado diretamente à barra.
Isto demonstrou o quão importante pode ser a colocação dos sensores.
Nos levantamentos terra e no supino, o movimento do pulso do atleta pode introduzir ruído adicional. O atleta está a segurar e a estabilizar a barra, pelo que o sensor não mede apenas o movimento vertical da barra. Mede também pequenos movimentos da mão, do pulso e do corpo.
Colocar o relógio diretamente sobre a barra reduziu um pouco desse ruído.
Isto não significa que a posição da barra seja sempre a melhor opção, nem que a posição do pulso esteja errada. Significa que o melhor algoritmo também tem de respeitar as limitações do hardware e a forma como o dispositivo está a ser utilizado.
Por mais avançada que seja a ciência de dados, nunca poderá compensar totalmente uma configuração de medição deficiente.
O que mudou no algoritmo do Spleeft
O novo algoritmo já saiu da fase beta. O verdadeiro teste consiste em verificar a consistência do seu funcionamento em diferentes exercícios, dispositivos e ambientes de treino. Quero que os treinadores possam avaliar isso por si próprios.
Também quero deixar claro o que se passa por trás desse número: o Spleeft utiliza os períodos de descanso detetados para limitar o desvio de velocidade e uma máquina de estados para identificar repetições. Testámos essas decisões com base em sessões gravadas e em dispositivos externos. Estou a partilhar a abordagem, mantendo, no entanto, os parâmetros exatos confidenciais.
O que aprendi
Este projeto ensinou-me que uma métrica de velocidade útil depende de mais do que um algoritmo engenhoso. Depende do sensor, do exercício, da qualidade dos dados e das decisões tomadas em cada etapa. A IA ajudou-me a explorar e a desenvolver mais rapidamente, mas a experiência de orientação foi essencial para decidir quais os problemas que realmente importavam.
O Spleeft continua a ser um projeto pessoal moldado por essa curiosidade. Vou continuar a testá-lo em treinos reais e a partilhar o que for aprendendo.